ガウス過程と機械学習ー1章、線形回帰モデル
仕事でベイズ最適化を試す機会があったが、中身をちゃんと理解できていなかったので、有名な『ガウス過程と機械学習』を買ってみた。あくまで個人的な勉強ノート。

単回帰
単回帰
個の観測地のペア(
)があったとき、
から
を以下のような一次式で予測することを単回帰という
切片 と係数
 の決定(最小二乗法)
単回帰の予測値 と実測値
の誤差の二乗を最小化するように係数
を決める方法。誤差の二乗を
とすると、
と書ける。
が最小となるとき、
についての微分が0となるので、
である。
これを整理して、 と略記すると以下が得られる。
この式について、行列形式で書いた式を単回帰の正規方程式と呼ぶ。
Pythonでやってみる
非常に単純な単回帰用のデータセットとして以下の場合を考える。
| x | y |
|---|---|
| -2 | 1 |
| 1 | 5 |
| 4 | 6 |
グラフに出力すると下のようになる。(凡例の答え、 はscikit-learnのLinearRegression()で計算した値)
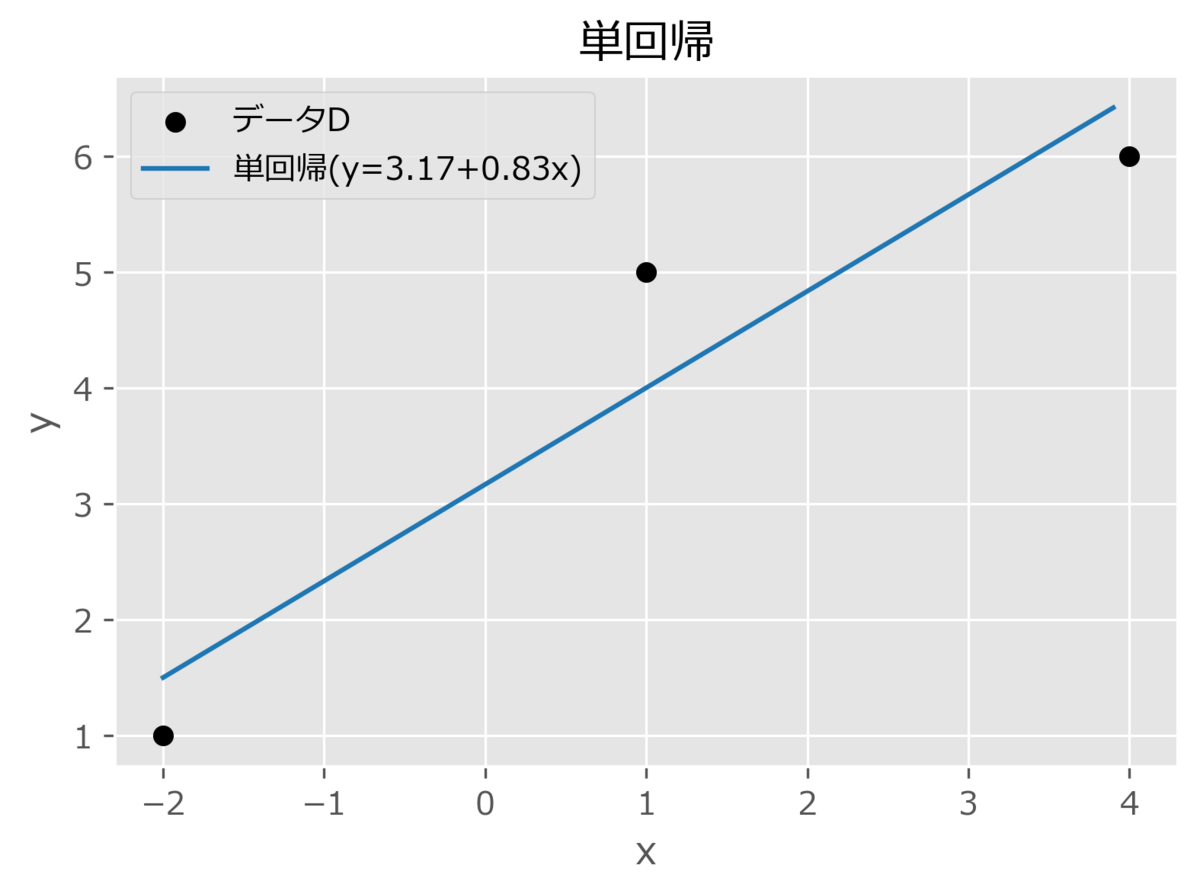
単回帰の正規方程式にデータを代入すると、であるから以下のようになる。
逆行列をnumpyのlinalg.inv()で計算してやると以下の通り。上記の答えと同じ切片と係数が計算できることがわかる。
import numpy as np

A = np.array([[3, 3], [3, 21]])
A_inv = np.linalg.inv(A) #逆行列を計算
b = np.array([[12], [27]])
w = A_inv @ b

print(w)
# [[3.16666667]
#  [0.83333333]]
重回帰
重回帰
入力が次元のベクトル
のとき、計算の都合上、最初の次元が必ず1となるように新しく定義したベクトルを
とする。ここで、切片を
、重み係数を
とおき、以下を求めることを重回帰という。
ここで個のデータについて並べると以下となる。ただし、
の関係を用いている。
ここで、上式の一番右辺の左側の行列は計画行列と呼ばれ、あるn番目の水準における入力変数のベクトルを
としたとき、
を縦に並べたものである。
※要するに以下のようなデータセットが存在した場合に、入力の最初の次元(変数)として1を加えた入力変数のデータセットそのものである。
データセット↓
| |
|
|
|---|---|---|
| 1 | 2 | 4 |
| -1 | 1 | 2 |
| 3 | 0 | 1 |
係数行列↓
これを用いると重回帰は以下の式となる。
重み係数ベクトル の決定(最小二乗法)
ベクトルの要素の二乗和は
と書けるので、誤差の二乗和は以下のようになる。
※以下では、
の関係を用いて
について括りだしてまとめる変形を行っている
このが最小になるように、重みベクトル
で微分すると、以下のようになる(※)。
よって、重回帰モデルの正規方程式は
であるから、が逆行列を持つならば、重み係数
は以下の式で求まる。
※ここではベクトルの一次式、二次形式の微分公式を使用している。
Pythonでやってみる
以下のようなデータセットを用いる
| 1 | 2 | 4 |
| -1 | 1 | 2 |
| 3 | 0 | 1 |
| -2 | -2 | -1 |
この重回帰をscikit-learnのLinearRegression()で計算すると、重み係数は以下のようになる。※は切片として別に計算される。
import numpy as np
from sklearn.linear_model import LinearRegression

#データD
X = np.array([[1, 2],[-1, 1],[3,0],[-2,-2]])
y = np.array([4, 2, 1, -1])

#重回帰
model_lr = LinearRegression()
model_lr.fit(X, y)

w0 = model_lr.intercept_
W = model_lr.coef_

print(w0)
# 1.2018779342723005
print(W)
# [-0.01643192  1.20892019]
一方で、計画行列を用いた行列計算においても同様の結果を得ることができる。
import numpy as np

X = np.array([[1,1,2],[1,-1,1],[1,3,0],[1,-2,-2]])
print(X)
# [[ 1  1  2]
#  [ 1 -1  1]
#  [ 1  3  0]
#  [ 1 -2 -2]]
y = np.array([4, 2, 1, -1])

X_T = X.T #転置

#計算
X_T_X_inv = np.linalg.inv(X_T @ X)
w = X_T_X_inv @ X_T @ y

print(w)
# [ 1.20187793 -0.01643192  1.20892019]
線形回帰
線形回帰(1変数)
単回帰のように1つの入力変数 と出力変数
のより複雑な関係性を表現したい場合には、
の関数
を
個用意して、表現力を向上させた線形回帰モデルを用いる。
※ここで、例えば に
や
を用いることで、複雑な関係性を表現できる。
※「線形」回帰は入力 と出力
の関係性が線形なのではなくて、重み
について線形和となっている、という意味である。
ここで個のデータ(
)について並べると、行列形式で以下のように書ける。
となり、すなわちとなる。このとき
が計画行列になる。
※ここではは入力変数
の具体的なデータ値であり、あくまで1変数
と
の関係を表現しようとしていることに注意する。
線形回帰(多変数)
上記の線形回帰について、入力変数がベクトルとなった場合にも容易に拡張することができる。
と定義すると、以下のようになる。
※このときは入力変数の集合であることに注意する。
特徴ベクトルと基底関数
ここで、 を特徴ベクトルと呼ぶ。線形回帰では、入力変数のベクトル
を
によって線形変換して、以下の線形モデルを適用していることに相当する。
※線形変換の結果、が
よりも高次元になる場合もある。例えば、
であり、
のような場合である。
重回帰モデルは線形回帰モデルにおけるとなるような特別な場合であると捉えることができる。
一方で、見方を変えると、以下の線形モデル
は、と
の関係を表す関数を、基底関数と呼ばれる、ベースとなる関数
の重み付き和として考えていることになる。
重み係数ベクトルの決定(最小二乗法)
線形回帰モデルの解は、重回帰モデルと同じ形であらわされるため、以下となる。
Pythonでやってみる
より実践的に、気象庁のHPで公開されている、世界の二酸化炭素(CO2)濃度の月別トレンドのグラフを線形回帰モデルで予測することを考える。
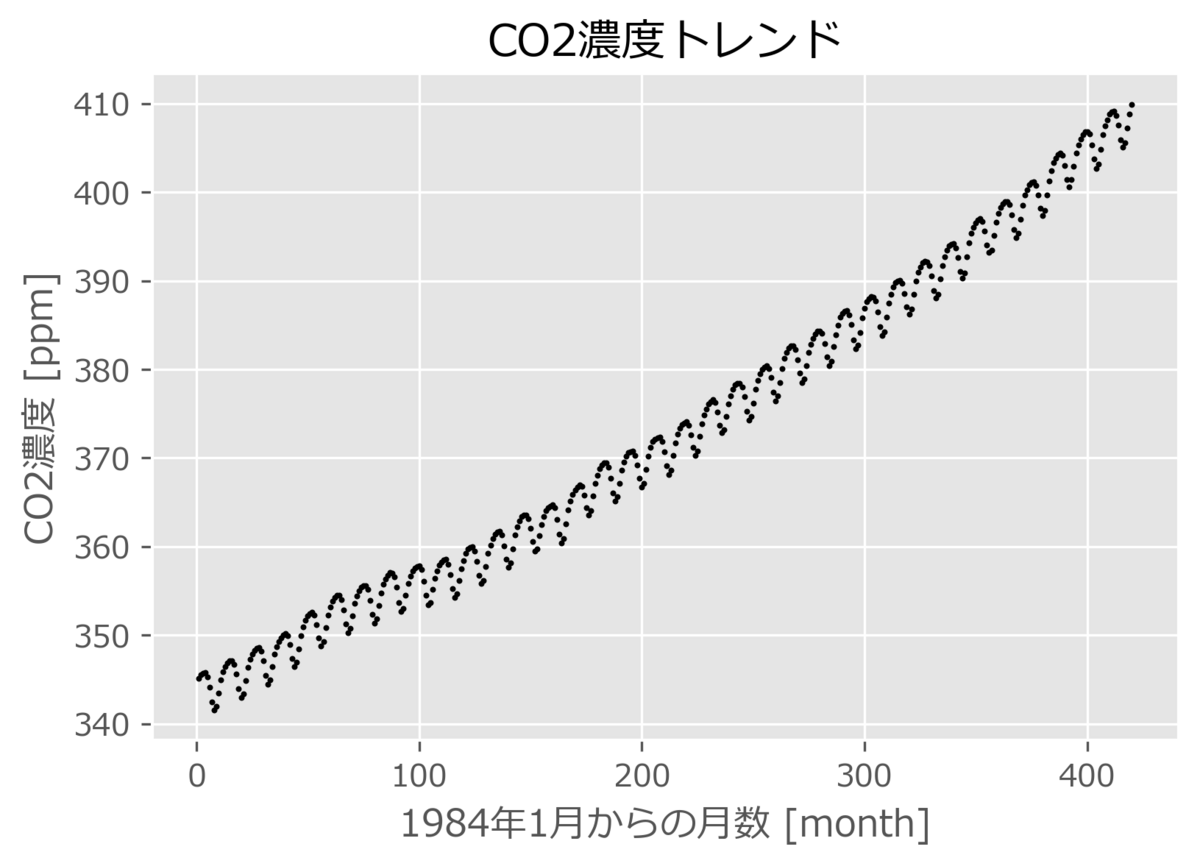
(出典:https://www.jma.go.jp/jma/kishou/books/hakusho/2020/csvindex.htm)
CO2濃度のトレンドには、周期的な(12か月単位の)季節変動がありつつも、全体としては上向きの曲線を示している。そこで、横軸である基準月からの月数を入力変数とし、特徴ベクトルとして以下を考えた。全体のトレンドを2次関数で表現し、周期変動をcosで表現することを狙っている。
※12か月周期の変動を表すため、とし、周期変動のうちCO2濃度がピークとなる月とのずれを考慮して、
と設定している。
import numpy as np
import pandas as pd

#計画行列を定義
def DesignMatrix(x):
    N = x.shape[0]
    Phi_x = np.c_[np.ones(N).T, x, x**2, np.cos(np.pi/6*x+2)]
    return Phi_x

df = pd.read_csv('co2_trend.csv')
x = np.array(df['month']).reshape((-1,1))
y = np.array(df['co2']).reshape((-1, 1))

Px = DesignMatrix(x)
Px_T = Px.T #転置

Px_T_Px_inv = np.linalg.inv(Px_T @ Px)
w = Px_T_Px_inv @ Px_T @ y

print(w)
# [[ 3.44455477e+02]
#  [ 1.01239502e-01]
#  [ 1.22992739e-04]
#  [-2.26796433e+00]]

#予測値を計算
y_pred = Px @ w
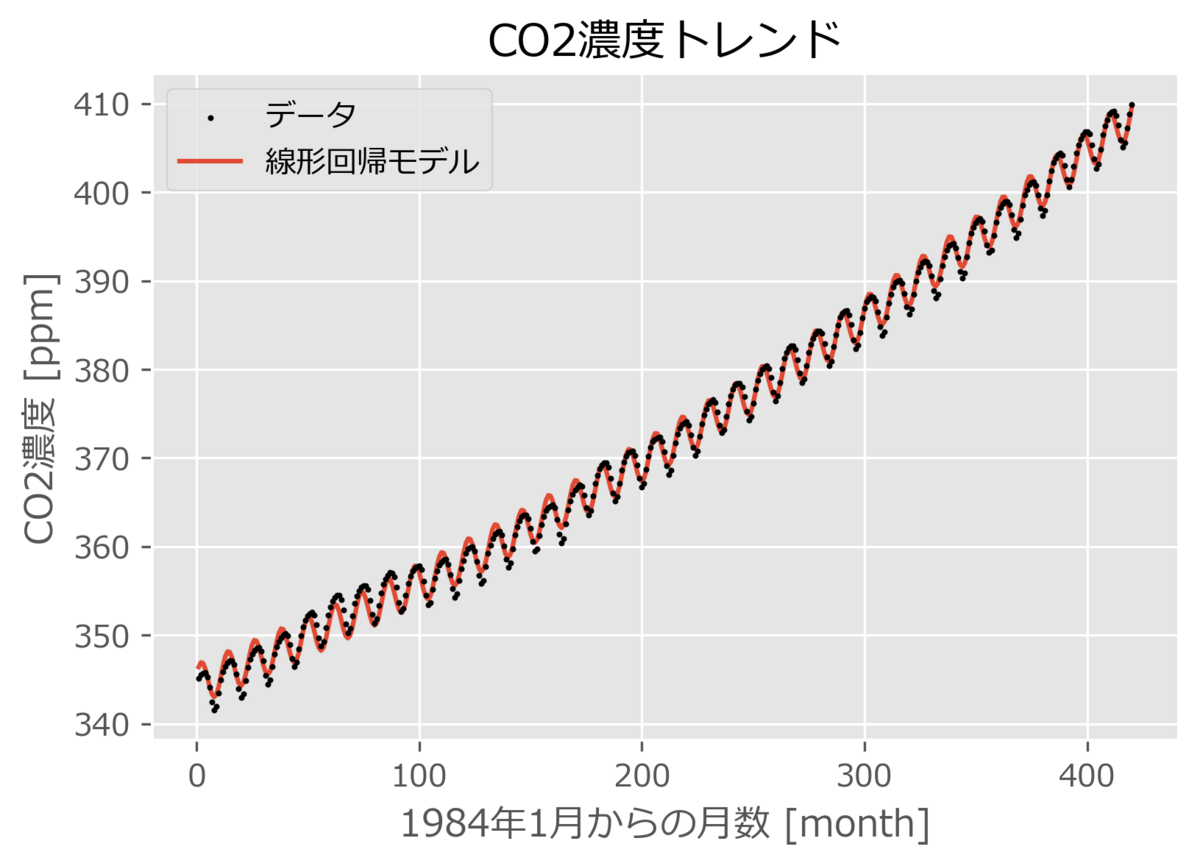
結果として、線形回帰モデルは以下のようになった。
また、モデルと実際のデータを比較するとモデルが良好にトレンドを予測できていることがわかる。